TechniqueRead in English
Une IA pour les langues du Bénin sur un petit serveur : ce qui marche, ce qui casse
Retour d'expérience technique : classement des traductions, confiance par mot, préchauffage et files d'attente sur CPU, mesures réelles et limites, y compris nos mauvais résultats en fon.
Notre démonstration traduit, transcrit et fait parler des langues du Bénin. Elle tourne sans carte graphique, sur un petit serveur à 4 cœurs et 8 Go de mémoire, allumé à la demande. Cet article raconte comment elle est construite, ce que nous avons mesuré, et surtout ce qui n'est pas encore bon. Les langues concernées sont peu dotées : peu de textes, peu d'audio, peu d'évaluations. Dans ce contexte, un système qui se contente de répondre est dangereux ; un système qui montre ses doutes et se laisse corriger est utile.
Voir la démonstration en vidéo : EnariLab · Démo : traduire, écouter et corriger les langues du Bénin
En bref
- Nous n'entraînons pas encore de modèle. Nous utilisons trois modèles ouverts de Meta : NLLB-200 (traduction), MMS (voix vers texte) et MMS-TTS (synthèse vocale). Ils sont publiés sous licence CC-BY-NC 4.0, donc la démonstration est un projet de recherche non commercial.
- Notre travail est autour des modèles : contrôler leurs sorties, signaler les doutes, classer les propositions, collecter des corrections consenties, et faire tenir tout cela sur du matériel modeste.
- Nous n'avons aucune évaluation quantitative (pas de BLEU ni de chrF publiés) tant que des locuteurs n'ont pas écrit de traductions de référence. Ce que nous racontons ici sont des mesures de temps et des constats qualitatifs.
L'architecture, en un schéma
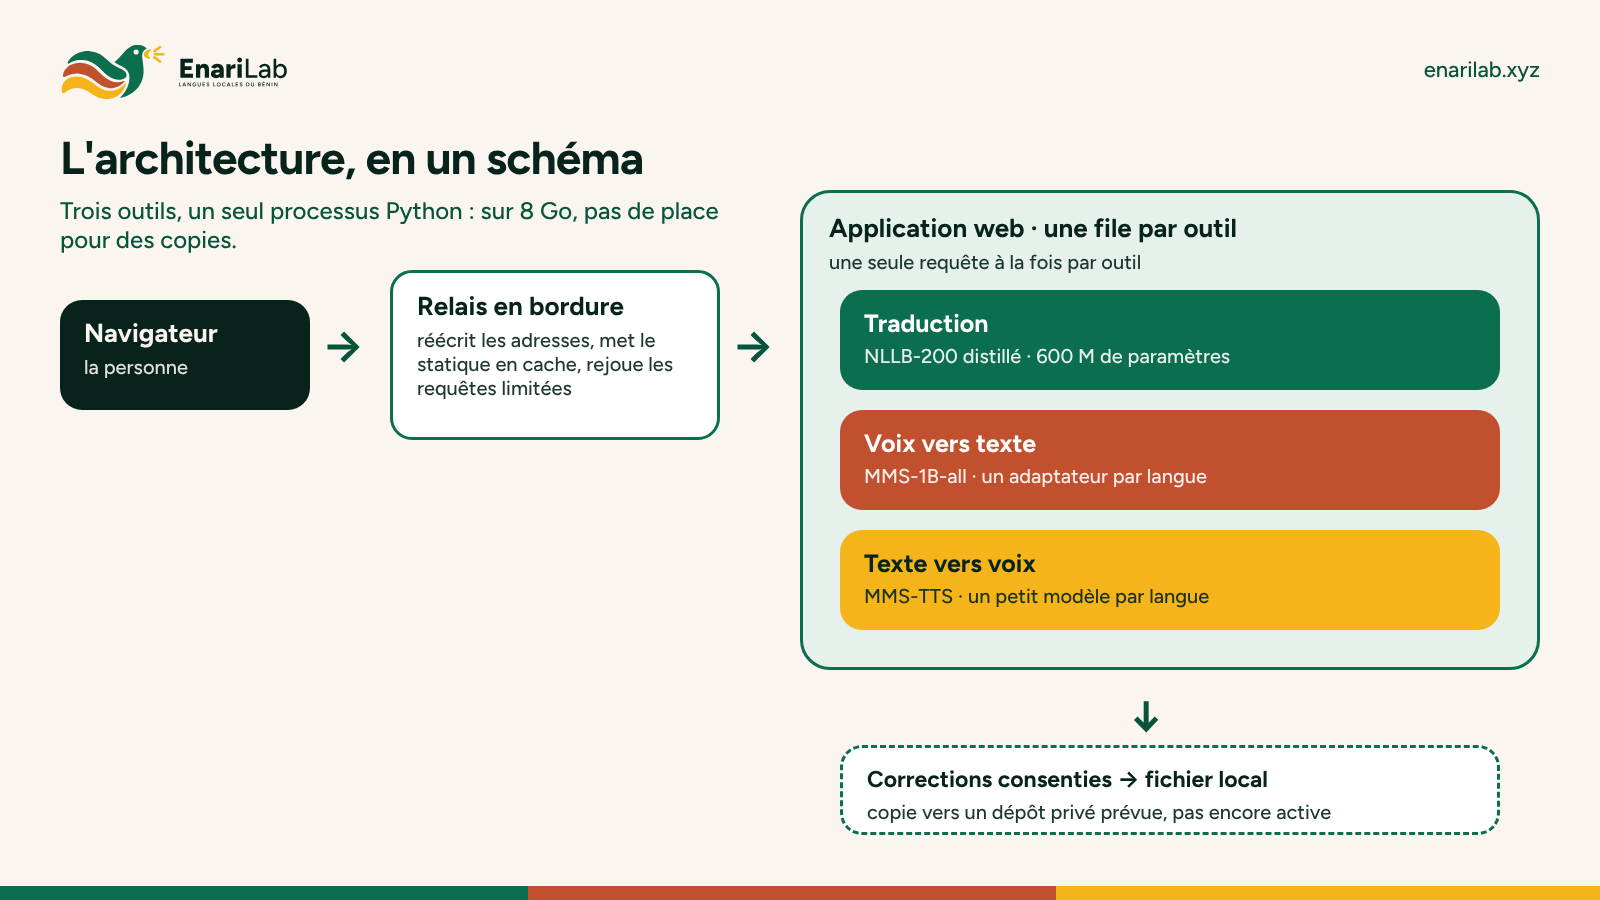
Les trois outils partagent le même processus Python. C'est volontaire : sur 8 Go, on ne peut pas multiplier les copies de modèles.
1. Traduire : générer, retraduire, classer
Un seul résultat de traduction cache l'incertitude. Nous demandons donc au modèle plusieurs candidates (recherche en faisceau de largeur 5, quatre candidates conservées), avec pour chacune la confiance du modèle : l'exponentielle du score de séquence, c'est-à-dire une probabilité moyenne par mot normalisée par la longueur. C'est une approximation, et elle n'est comparable qu'entre candidates de la même phrase.
Chaque candidate est ensuite retraduite vers la langue de départ, et on mesure la ressemblance entre la phrase d'origine et la retraduction avec un chrF implémenté sans dépendance (F-score sur les n-grammes de caractères).
Le score final combine les deux signaux, avec plus de poids sur l'aller-retour que sur la confiance, puis retire des points pour des défauts reconnaissables : sortie vide, simple recopie de l'original, répétitions en boucle, longueur aberrante. Les valeurs exactes sont des réglages de départ, pas des vérités, et nous ne les publions pas : le principe compte plus que les chiffres.
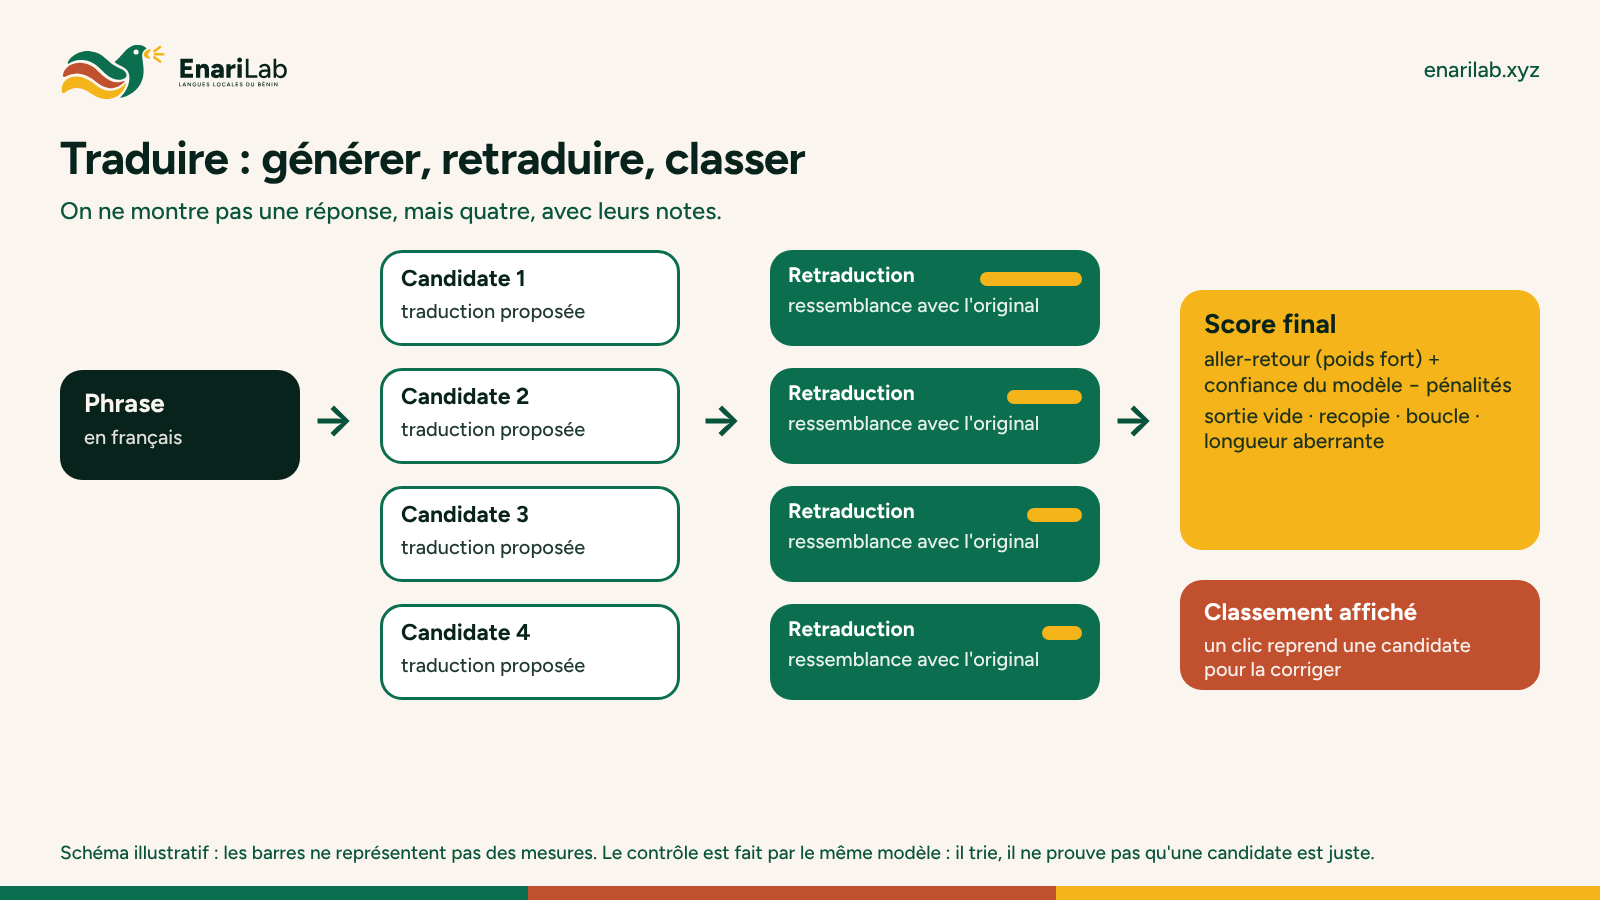
Pourquoi donner plus de poids à l'aller-retour ? Pour ces langues, le modèle est souvent très sûr de lui quand il se trompe. Sa confiance seule ne sépare pas le bon du faux. L'aller-retour attrape surtout les traductions hors sujet.
Ce que cela ne prouve pas. C'est un contrôle faible : la retraduction est faite par le même modèle, ce n'est donc pas une vérification indépendante. Le score trie les candidates, il ne dit pas si l'une d'elles est juste. L'interface montre toutes les candidates avec leurs notes, et un clic en reprend une pour la corriger. Seul un locuteur tranche.
Chaque demande produit aussi une trace : les étapes (préparer, générer, retraduire, classer), leur durée et les scores, visibles dans « Détails techniques » et retournées en JSON par l'API.
2. Voix vers texte : une confiance par mot
MMS est un modèle à décodage CTC. Au lieu de prendre la sortie finale telle quelle, nous refaisons le décodage glouton nous-mêmes, trame par trame, en gardant la probabilité de chaque lettre :
# Principe (simplifié) : fusion des répétitions, retrait du « blanc », mots séparés par le séparateur
for t, symbole in enumerate(ids):
    if symbole == precedent:            # même lettre qu'à la trame d'avant
        confiances[-1] = max(confiances[-1], proba[t])
        continue
    precedent = symbole
    if symbole in (blanc, *speciaux):   # rien à écrire
        continue
    if symbole == separateur:           # fin de mot : confiance du mot = moyenne de ses lettres
        fermer_mot()
        continue
    lettres.append(vocabulaire[symbole]); confiances.append(proba[t])
La confiance d'un mot est la moyenne de celles de ses lettres, et celle d'une lettre est la plus haute de ses trames. Les mots sous un seuil sont surlignés « à vérifier » : la personne qui corrige sait où regarder en premier.
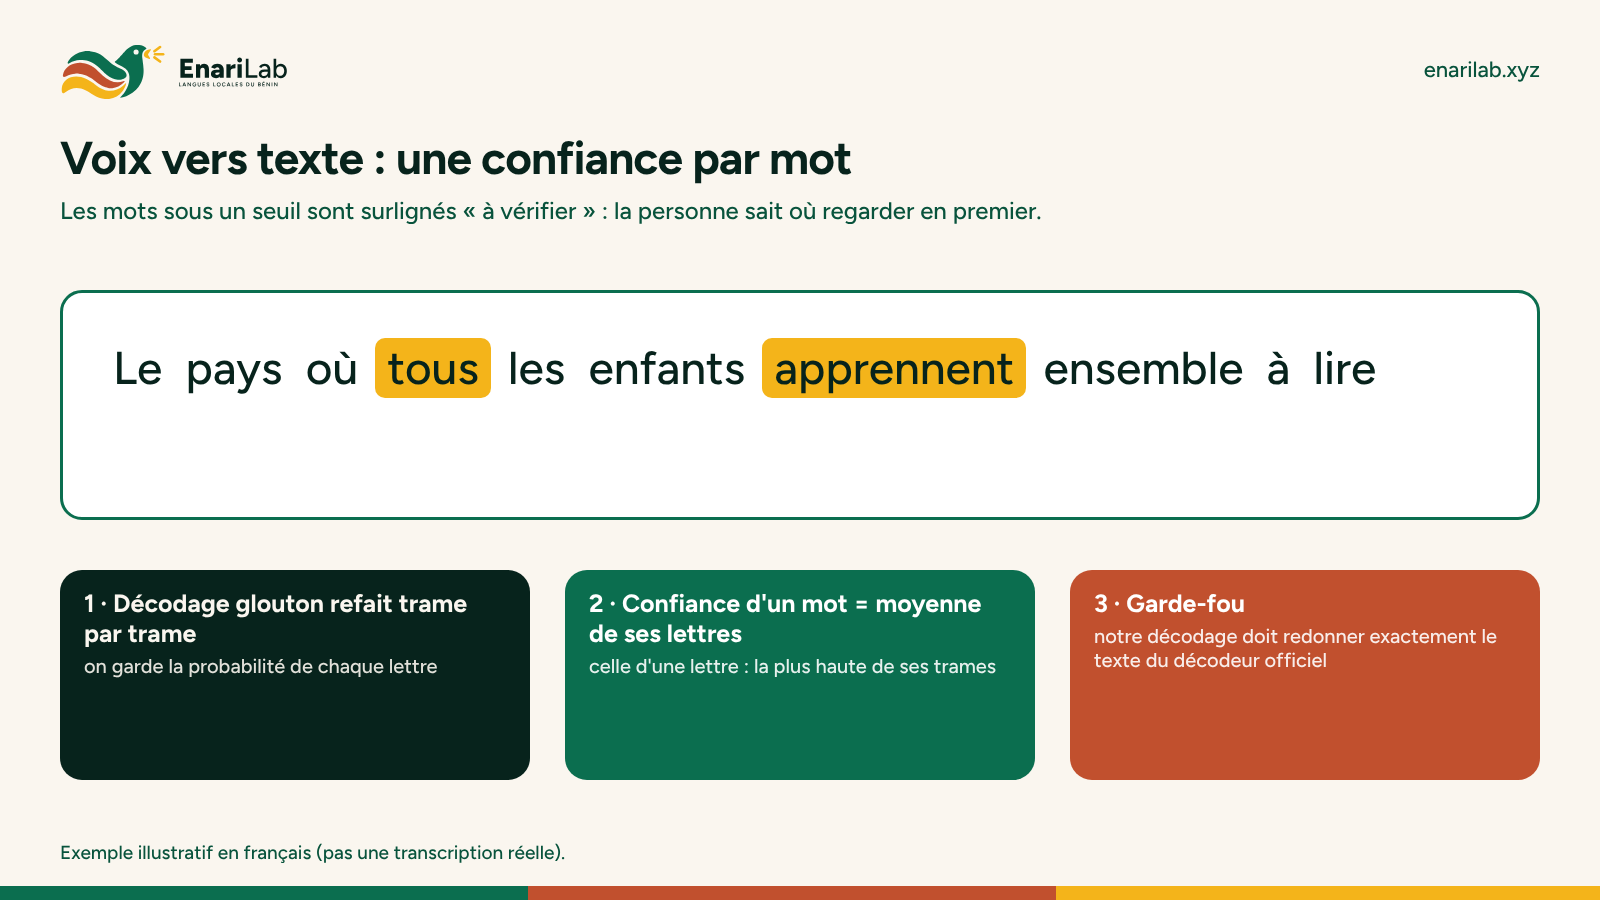
Deux garde-fous : notre décodage doit redonner exactement le texte du décodeur officiel (le contrôle est enregistré dans la trace), et l'audio est borné à 30 secondes, mono, 16 kHz, pour que le processeur reste réactif.
MMS-1B-all contient un adaptateur par langue. Il se charge avec l'adaptateur anglais, puis change d'adaptateur selon la langue demandée. L'adaptateur et le vocabulaire sont un état partagé : toute la chaîne se fait sous un verrou, et en cas d'échec de changement d'adaptateur on remet l'état à « inconnu » pour recharger la fois suivante.
3. Texte vers voix : des caractères que la voix ne connaît pas
Les voix MMS-TTS (VITS, une petite voix d'environ 140 Mo par langue) ont un vocabulaire au niveau du caractère. Les langues du Bénin utilisent des tons et des lettres comme ɔ, ɛ, ɖ, ŋ, et leur forme Unicode compte : la même lettre accentuée peut être écrite en un seul caractère (forme composée) ou en deux (forme décomposée). Pour chaque texte, nous essayons les deux formes, gardons celle qui perd le moins de caractères, et disons à la personne quels caractères la voix a ignorés.
Autre choix : la graine aléatoire est fixée, donc le même texte donne toujours le même son (VITS est stochastique sinon). Et la voix de synthèse n'est jamais conservée avec les corrections.
Limite à connaître : pour beaucoup de langues, ces voix ont été apprises surtout sur des lectures de la Bible. La prononciation et les tons peuvent être faux, et l'interface l'écrit.
4. Exploiter tout cela sur un CPU
Mémoire
En 32 bits, un modèle de 600 millions de paramètres occupe de l'ordre de 2,4 Go, et un modèle de 1 milliard de paramètres de l'ordre de 4 Go. Avec 8 Go au total, on ne peut pas tout charger d'avance : la traduction et les trois voix principales tiennent, la voix vers texte n'est préchargée que s'il reste assez de mémoire disponible (nous lisons la mémoire disponible du système au démarrage).
Le premier appel
Chargement paresseux : un modèle n'était chargé qu'au premier clic. Résultat : la première personne attendait 15 à 30 secondes devant une page muette, et les suivantes derrière elle. Nous avons remplacé cela par un préchauffage au démarrage, dans un fil d'arrière-plan : la page répond tout de suite, le modèle de traduction est chargé et fait un premier calcul à blanc, puis les voix. Tant que ce n'est pas fini, la page le dit.
Mesures informelles, une seule série, pas un banc d'essai :
| Appel (serveur 4 cœurs, sans carte graphique) | Durée |
|---|---|
| Traduction classée (4 candidates, 4 retraductions), 1ᵉʳ appel après préchauffage, de bout en bout | environ 4 s |
| Traduction + voix ewe, 1ᵉʳ appel | environ 8 s |
| Une traduction et une voix en même temps | 6,4 s et 7,2 s |
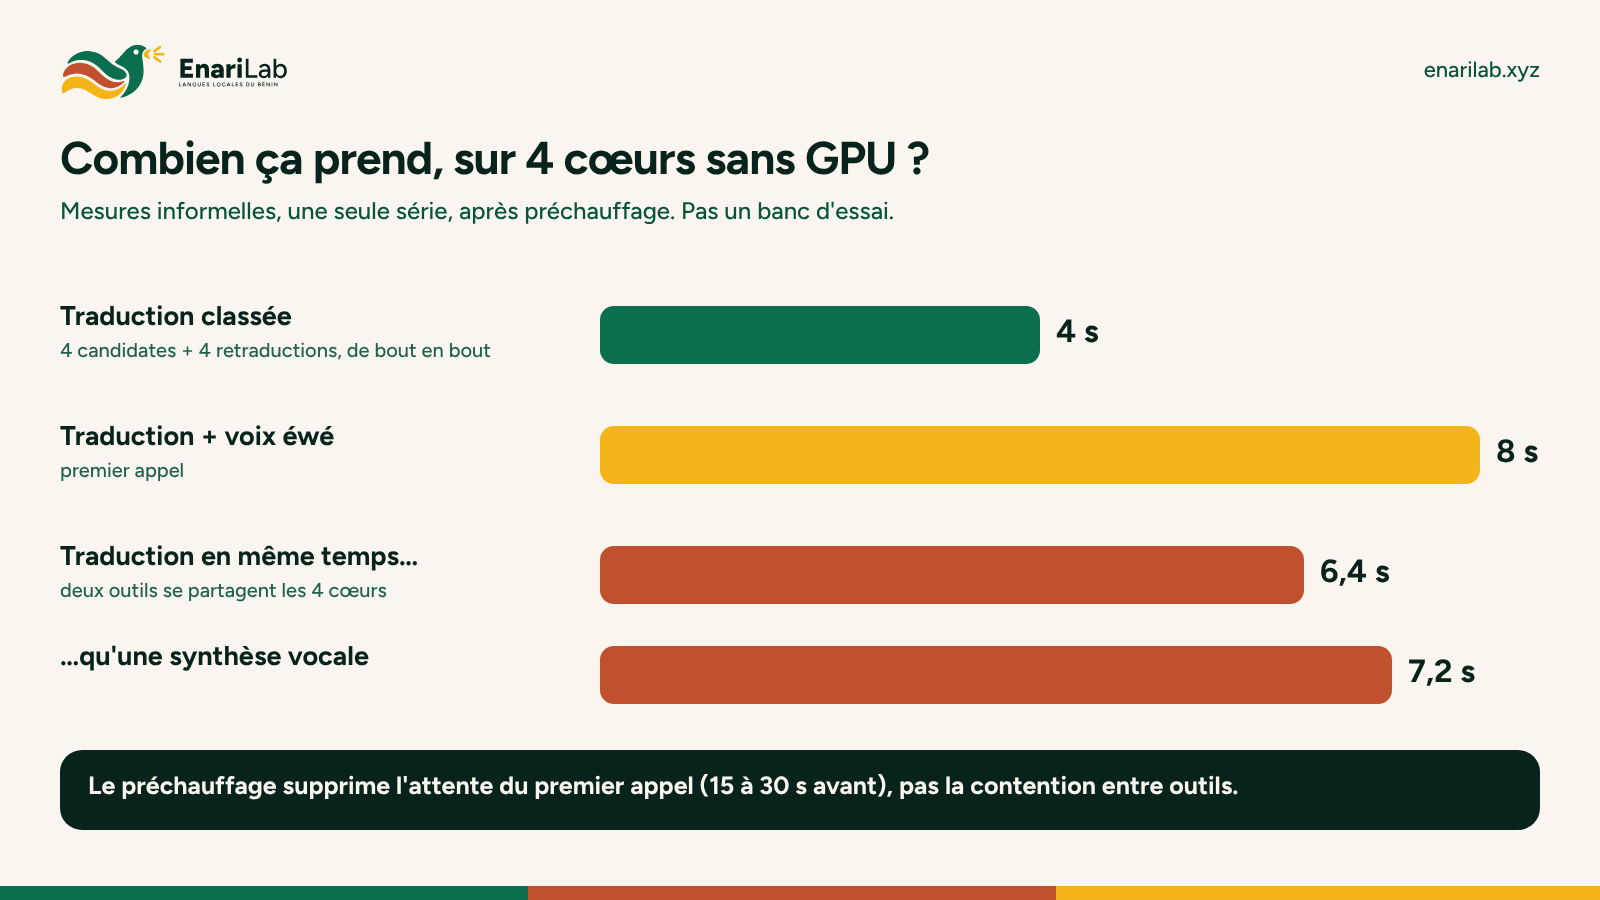
La dernière ligne montre la limite : deux outils qui calculent en même temps se partagent les 4 cœurs. Le préchauffage supprime l'attente du premier appel, pas la contention.
Files d'attente
L'application web gère une file par outil (traduction, voix vers texte, synthèse), avec une seule requête à la fois par outil : le modèle et son état sont partagés, et chaque modèle a en plus son verrou. Ainsi une transcription lente ne retarde plus une traduction. Plus de parallélisme sur un même outil n'aiderait pas : le processeur est déjà saturé.
bouton.click(traduire, entrees, sorties, api_name="translate", concurrency_id="traduction")
demo.queue(default_concurrency_limit=1, max_size=40)
Ce qui a cassé, et ce que nous en avons retenu
- Un indicateur de file invisible. Notre refonte cachait la zone de résultat tant que la traduction n'était pas arrivée. Or l'indicateur de file de l'interface s'affiche sur les composants de sortie : il était donc posé sur un élément caché, et la personne voyait « rien ». Correctif : le résultat s'ouvre dès le clic, le bouton se verrouille, et un message dit ce qui se passe.
- Des processus orphelins. Notre script de redémarrage n'arrêtait que le processus principal du « maintien en éveil » (l'hébergeur met en pause une machine inactive au bout d'environ 30 minutes), pas ses enfants. Chaque redémarrage en laissait. Résultat : une charge de 12 sur 4 cœurs et une application qui ne répondait plus. Nous arrêtons maintenant tous les processus du script à chaque redémarrage.
- Un relais en bordure. L'ingress de l'hébergeur limite le débit : sans relais, la page de la démo restait sur « Loading… ». Le relais réécrit l'adresse de l'hébergeur, met le statique en cache et refait les requêtes refusées pour cause de limite de débit.
5. L'API
Le service expose huit points d'accès nommés, dont la forme est figée pour ne pas casser les outils qui l'appellent : traduire, traduire avec le détail du classement, transcrire, transcrire avec la confiance par mot, parler, traduire puis parler, et deux points d'envoi de correction. Les variantes « détaillées » renvoient le JSON complet : propositions, scores, alertes, étapes et durées. Les événements purement visuels de l'interface sont masqués de l'API, et les états internes ne s'y exposent pas, pour que le contrat reste stable quand l'interface évolue.
Nous gardons volontairement l'API sans état de session : chaque appel contient tout ce qu'il lui faut, et rien d'une personne n'est conservé entre deux appels.
6. La boucle de correction
Quand la personne corrige et envoie, et seulement si elle coche le consentement, nous enregistrons : le texte ou l'audio, la correction, la langue, la date, le modèle utilisé, les propositions de l'IA avec leurs scores et le rang de celle qu'elle a reprise, un indicateur « inchangée » et un indicateur « locuteur natif ». Jamais de nom, d'email ni d'adresse IP. Les corrections sont écrites localement ; une recopie vers un dépôt de données privé est prévue, mais pas encore activée à ce jour.
Ce choix de stocker les propositions et le rang a une raison scientifique : il permettra de vérifier plus tard si notre classement aide vraiment, en regardant si les locuteurs reprennent plus souvent les candidates que nous plaçons en tête.
Un détail de confidentialité : l'interface écrit l'audio importé dans un cache temporaire avant le consentement ; ce cache est purgé automatiquement au bout d'environ une heure, pas immédiatement.
7. Ce qui est mauvais ou non évalué
Nous préférons le dire clairement :
- Le fon est mal traduit. Nos premières lectures montrent des traductions manifestement mauvaises. C'est le problème que la démonstration veut mettre en lumière, pas un résultat dont nous sommes fiers.
- Aucun score publiable. Nous n'avons pas de traductions de référence écrites par des locuteurs. Un script d'évaluation existe (il comparera notre classement au premier choix brut du modèle), mais il attend ces références.
- Le classement est une heuristique. Mêmes réserves que plus haut : aller-retour par le même modèle, confiance souvent élevée sur de mauvaises sorties, réglages non ajustés.
- Sept langues en voix seulement. Le baatonum, le dendi, le ditammari, le gen, le naténi, le waama et le yom ont une voix et une transcription, mais aucun modèle de traduction ne les couvre, et leur qualité n'a pas été jugée par un locuteur. Elles sont éteintes par défaut.
- Voix vers texte peu testée sur de vraies voix. Les cas limites de lecture audio sont testés (formats, silence, fichier trop court ou corrompu) ; l'évaluation sur de vraies voix locutrices reste à faire.
Prochaines étapes, et comment aider
- Faire écrire des traductions de référence par des locuteurs, pour mesurer et ajuster le classement.
- Faire juger les voix par des locuteurs, langue par langue, avant d'ouvrir les sept langues restantes.
- Mesurer sur de vraies voix la fiabilité de la confiance par mot.
- À terme, passer des modèles de base à des petits modèles ajustés sur les données consenties.
Vous parlez une langue du Bénin, vous êtes linguiste ou vous développez ? Vous pouvez demander une démonstration, ou rejoindre la liste des contributeurs. Chaque correction envoyée est exactement la donnée qui manque.